AI Agent · N.O.V.A. 2026
MedDB
공들인 기능을 더하는 대신, 최종 구성을 줄이기로 했습니다.
- Role
- AI Agent Developer
- Period
- 2026.10
- Focus
- 관찰 근거 추적 · 의료 온톨로지 · 회귀 분석
프로젝트 이야기
공들인 기능을 더하는 대신, 최종 구성을 줄이기로 했습니다.
- 최종 후보 B1O1 · 공개 3증례 샘플 평가
- 77.498 / 100기존 기준안 E2 77.714보다 0.216점 낮음
- 대회에 제출한 최종 후보 B1O1
- 리더보드 미확인공개 3증례 샘플 평가와 구분
- 공개 샘플 평가 안전 항목
- 15 / 15임상 안전성 검증이 아님
문제와 발견
의료 AI 대회 N.O.V.A. 2026에 팀으로 나갔습니다. 가상 환자에게 질문하고, 그 대답을 근거로 진단과 진료기록을 쓰는 AI를 만드는 대회입니다. 팀의 목표는 리더보드 78점이었습니다. 의료 지식을 미리 촘촘하게 정리해 두면 점수가 오를 거라 믿고 가장 많은 시간을 썼습니다. 점수는 움직이지 않았습니다. 점검해 보니 그 사이 데이터 정리나 AI에게 주는 지시문 다듬기 같은 기본기가 비어 있었습니다.
제약과 선택
기본기부터 하나씩 다시 만들고, 단계마다 점수를 확인했습니다. 그런데 더한 기능에서 뚜렷한 이득이 보이지 않았고, 어떤 조합은 점수가 크게 낮았습니다. 이득을 확인하지 못한 기능은 아깝더라도 최종 구성에서 뺐습니다. 다만 버전마다 실행 조건이 달라, 각 기능의 영향을 따로 입증하지는 못했습니다. 최종안은 샘플 점수만 보고 고르지 않았습니다. 기존 E2는 샘플 77.714점이었지만 리더보드에서는 67.132점이었고, 팀원의 B1은 리더보드 70.02점이었습니다. 최종 후보는 B1에, 진료기록이 실제로 들은 대답에 근거하도록 AI의 질문과 환자의 실제 대답을 짝지어 남기는 기능을 추가 모델 호출 없이 더한 B1O1이고, 이를 대회에 제출했습니다.
본인 기여
제가 맡은 범위: AI 코딩 도구를 활용해 실험 환경을 구성하고, 검색과 기록 방식을 실험했습니다. 결과와 실패 양상, 가능한 원인을 분석했고, 최종 후보의 질문과 대답 연결 기능과 모든 결정의 기록을 맡았습니다. 활용한 팀 자산: 팀의 기존 의료 지식 자산과 E2, B1 에이전트입니다. 최종 후보 B1O1은 팀원이 만든 B1을 바탕으로 했습니다.
검증과 한계
최종 후보 B1O1의 샘플 점수는 팀의 기존 기준안 E2(77.714점)보다 0.216점 낮았습니다. 대회에 제출했지만 리더보드 성적은 확인하지 못해, 목표 78점을 넘었는지도 알 수 없습니다. 개선했다고 말할 수 없는 결과라서 기록에 그대로 남겼습니다. 점수는 공개 3증례 샘플 평가이며, 버전마다 실행 조건이 달라 기능별 효과를 직접 비교할 수 없습니다. 최종 후보의 안전 항목 15점 만점은 대회 채점 기준이며, 임상 안전성 검증이 아닙니다.
배운 점과 다음 시도
다음 실험에서는 기능을 붙이기 전에 비교 기준과 평가 조건부터 정하겠습니다.
제출 상태 추가 확인: B1O1은 대회에 제출했지만 리더보드 성적은 확인하지 못했습니다. 아래 2026년 10월 23일 연구 기록의 77.498점은 공개 3증례 샘플 평가 결과입니다.
관찰 근거와 의료 온톨로지를 결합한 진료 에이전트의 설계·실험·회귀 분석
Design, Experiments, and Regression Analysis of an Observation-Grounded Medical Agent
N.O.V.A. 2026 기술 사례연구 · 기준일 2026-10-23 · 최종 후보 B1O1
개발 종료 시 작성한 연구 기록이다. 동료 심사를 받은 논문이나 임상 검증 결과가 아니다. 이 문서는 저장소 메인 연구 기록이다.
초록
제한된 상호작용 예산에서 가상 환자의 실제 응답과 진찰 결과를 수집하고, 의료 지식과 대조하여 진단 및 SOAP를 생성하는 Doctor Agent를 개발하였다. 기존 팀 MedDB와 E2를 비교·재사용 자산으로 삼아 독립 하네스, 근거 원장, 감별 수렴 관찰, 지침 검색, 역할 분리 프롬프트, LangGraph, 안전 의무 검증, 모델 주도 질문 선택을 실험하였다. 주요 실패는 원문 보존과 정보수집 성능 사이의 간극, 계획과 실제 교육의 혼동, 경고 축약·미전달, 문자열 검증의 과도한 거절, 중복 모델 호출에 따른 비용 증가였다.
최종적으로 팀원이 개발하여 main에 병합한 B1을 기반으로, 추가 추출 모델 호출 없이 질문–응답 출처와 보수적 관찰 해석을 연결한 B1O1을 구성하였다. 사용자 제공 서버 샘플 검증은 77.498/100, 안전 15/15였다. Q1의 65.288보다 12.210점, R3a의 76.290보다 1.208점 높지만 초기 E2 샘플 77.714보다 0.216점 낮다. 실행 시점과 여러 구성요소가 달라 단일 모듈의 인과 효과를 주장하지 않는다. 리더보드 목표 78·85·90 달성은 확인하지 못했다. 본 사례는 기능 누적보다 관찰 출처·행동 예산·실제 설명·기록의 일치성을 검증하는 중요성과 한계를 보여준다.
핵심어: 의료 에이전트, 온톨로지, SOAP, 근거 추적, RAG, 안전 전달, 회귀 분석
문제 정의와 초기 구상
출발점은 기존 에이전트의 점수 정체였다. 사용자는 의료 온톨로지와 프롬프트·하네스를 결합하고, 개발 API 실행 → 로그 분석 → 가설 → 수정 → 비교의 순환으로 개선하기를 요청하였다. 목표는 리더보드 78 → 85 → 90이었다. 환자의 답변을 임의로 생성하는 대신 실제 환자 API의 응답과 진찰 결과를 근거로 감별 후보를 좁히고 SOAP를 작성하는 것이 핵심 원리였다.
연구 질문은 ① 원문과 구조화 관찰의 병행 보존이 정보 소실과 잘못된 정상화를 줄이는가, ② 온톨로지와 검색 근거가 문진·감별·기록을 개선하는가, ③ 안전 계획과 실제 전달 사이의 간극을 줄일 수 있는가, ④ 추가 추론 비용이 이득을 상쇄하는가였다.
Doctor는 openai/gpt-6-luna이며 SAY/EXAM 행동 길이와 최대 50턴의 계약 아래 진단·SOAP를 제출한다. 최신 계약은 공식 개발 가이드를 기준으로 하였다.
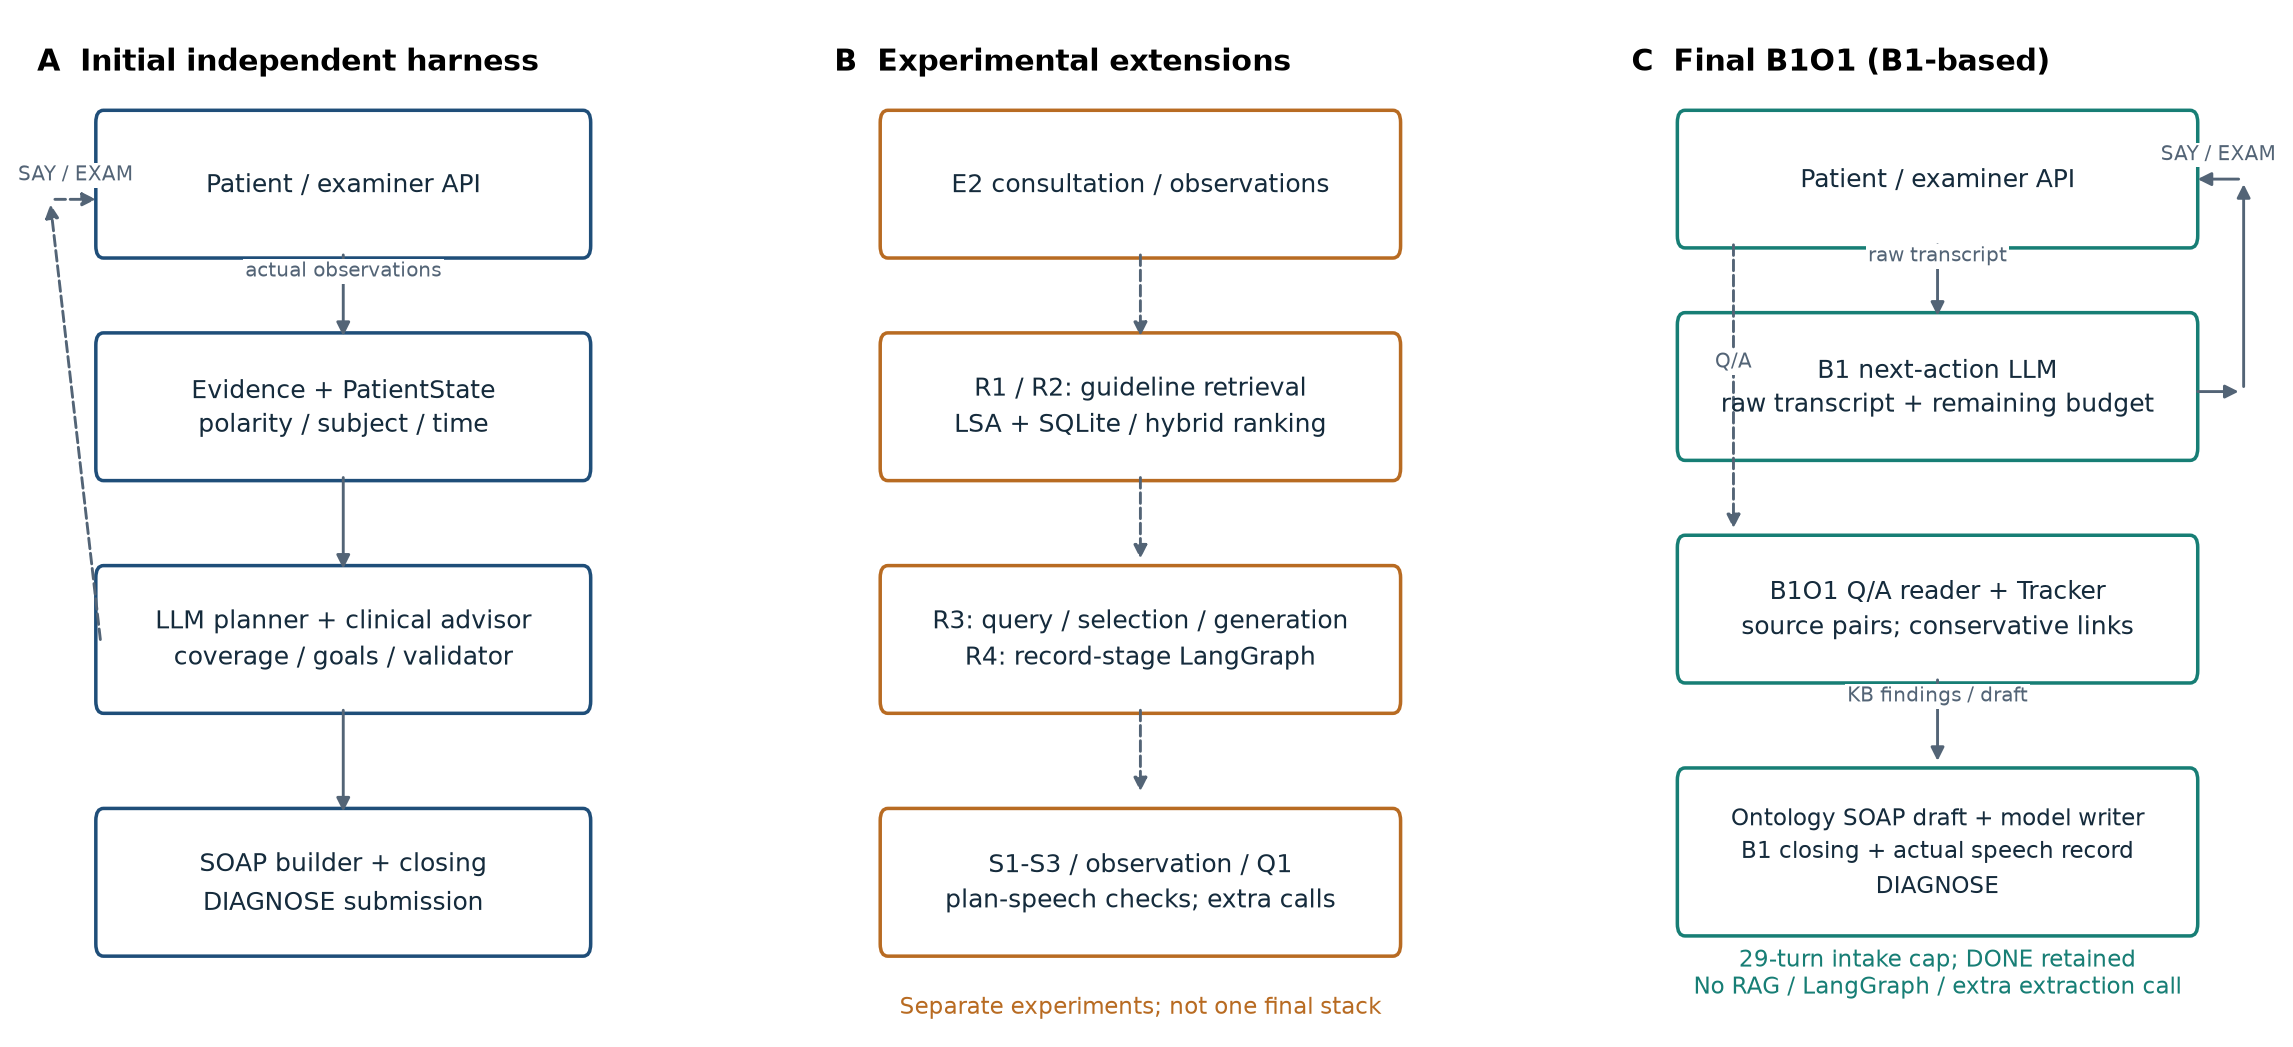
그림 1. 왼쪽은 초기 독립 하네스, 가운데는 별도의 실험 확장, 오른쪽은 최종 B1O1이다. 가운데 모듈을 모두 최종본에 누적한 것이 아니다. 최종 다음 행동 모델의 입력은 원문 대화와 예산이며 reader 상태가 별도 질문 선택기를 직접 구동하지 않는다.
의료 지식 및 온톨로지 구축
MedDB의 기존 팀 자산을 재사용·확장하였다. DisMech, DDXPlus, KCD/HIRA 등 참조 자산과 임상 저작 부분집합을 구분하며 모두 이번 개발자가 새로 구축했다고 주장하지 않는다. 임상 저작 자료는 검수 전 초안을 포함한다.
참조 스키마는 Concept, Disease, Finding, Test, Assertion, Source, Mapping과 관계·출처·검수 상태를 표현한다. 주호소·질환·소견·진찰·질문 슬롯·계획은 저작 자료에서 런타임 JSON으로 컴파일하며 참조 무결성과 행동 길이를 점검한다. 형식 검사는 임상 타당성 검증을 대신하지 않는다. 최종 에이전트는 전체 참조 그래프를 OWL 추론기로 실행하지 않는다.
| 계층 | 실제 규모 | 해석 |
|---|---|---|
참조 릴리스 meddb-2026.10.13.1 |
개념 32,585 / assertion 114,092 / 출처 3,345 | 기존 팀 참조 지식 |
| 임상 런타임 | 주호소 19 / 질환 135 / 소견 291 | 에이전트용 부분집합 |
| 행동 자산 | 진찰 56 / 슬롯 19 | 증례별 선택 자산 |
| 질환–소견 관계 | key 384 / support 507 / against 135 / rule_out 51 | 저작 연관이며 진단확률 아님 |
RAG 네 단계의 구현 범위
| 계획 | 실제 구현 | 미구현·제외 |
|---|---|---|
| 청킹·임베딩·벡터 저장 | 지침 4,488·청크 158,727, TF-IDF→SVD 64차원 LSA, int8 벡터 SQLite | 사전학습 신경망·원격 벡터 DB 아님 |
| 유사도 검색 개선 | R1 정규화 코사인에 R2 BM25·코사인 RRF·coverage 재정렬 | MMR·ANN 미구현 |
| 세 프롬프트 역할 | R3a 적합성 선별, R3b 질의 계획, R3c 기록 생성 | R3c 단독 서버 결과 없음 |
| LangGraph | 기록 단계 검색·선별·생성 조율·재생 검사 | 문진 정책·능동 수렴·조기 종료를 대체하지 않음 |
지침 원문은 경로·해시·행 위치로 확인하였고 공개 정답·모범 기록을 런타임에 넣지 않았다. LSA를 신경망 임베딩으로 표현하지 않는다. 최종 B1O1에는 RAG/LangGraph를 결합하지 않았다.
서버 샘플 검증 결과
| 버전 | 총점 /100 | 정보 /25 | 진단 /15 | 검사·추적 /10 | 안전 /15 | 소통 /15 | 효율 /20 |
|---|---|---|---|---|---|---|---|
| E2 | 77.714 | 11.94 | 15.00 | 8.64 | 15.00 | 7.72 | 19.42 |
| R3a | 76.290 | 12.04 | 15.00 | 8.64 | 15.00 | 6.72 | 18.89 |
| Q1 | 65.288 | 10.04 | 12.78 | 7.97 | 13.75 | 7.72 | 13.02 |
| B1O1 | 77.498 | 12.37 | 14.44 | 8.61 | 15.00 | 8.06 | 19.02 |
각 행은 공개 3증례의 한 제출 집계다. 실행 시점·환자 경로·모델 출력·코드가 달랐고 반복 무작위 대조·신뢰구간·통계적 유의성을 확보하지 못했다. 영역 점수는 반올림되므로 총점은 서버 표시값을 유지한다.
최종 B1O1
팀원 PR6가 병합된 main 05f9ed0을 일반 병합하였다. B1에는 선택적 reader 연결만 추가하고 agent_b1_observed.py·reader_b1_observed.py로 후보를 분리했다. 기본 B1을 자동 교체하지 않았다.
- B1 다음 행동 모델이 실제 원문 대화와 예산으로 질문·진찰·DONE을 선택한다.
- reader가 실제 질문–응답과 턴을 보존한다. 표준 단일 질문의 짧은 긍정·부정을 보수적으로 연결하고 가족·과거·부분·모호함은 무리하게 현재 이진 소견으로 바꾸지 않는다.
- Tracker와 지식으로 SOAP 초안을 보조하며 최종 기록 모델에 원문 대화를 제공한다. 질문 완료와 현재 소견은 구분한다.
- B1의 29턴 문진 상한·DONE·마무리를 유지한다. 29는 전체 상호작용 총수가 아니므로 최종 40–41턴과 모순되지 않는다.
Q1 선택기·추가 모델 추출·RAG·LangGraph는 최종본에 없다. reader는 보수적 규칙 기반이며 완전한 의료 언어 이해 엔진이 아니다. 실제 세 세션에서 짧은 예/아니요 single_question_link 분기는 0회여서 해당 기능 효과는 합성 검증에 한정된다.
저장소 루트 143테스트(4 skip), 기존 하네스 331테스트, B1·후보 각 3개 API 세션 및 6개 엄격 재생을 확인하였다. 진찰 거절·제공자 오류는 남았다. 압축 해제본 3증례 입력·행동·SOAP 일치를 확인했지만 Docker·공식 실행 환경의 별도 검증은 아니다.
최종 강평과 한계
성과: 관찰·지식·행동·실제 전달·SOAP를 구분하는 실험 체계를 만들고 실패와 비용도 남겼다. 마지막에는 팀원의 B1에 관찰 연결을 제한적으로 추가하여 샘플 77.498·안전 15를 확보하였다. 실패한 후보를 최종 기능으로 숨기지 않고 동결 자산·재생 근거를 보존하였다.
성능 평가: 초기 E2 샘플 77.714를 넘지 못했으므로 전체 개발이 최고 성능을 갱신했다는 결론은 성립하지 않는다. Q1에서 회복했지만 reader 단독 효과는 분리하지 못했다. R3a·B1O1의 안전 15도 임상 안전성의 증명은 아니다. 리더보드 목표 78·85·90은 달성 확인 없이 종료하였다.
핵심 교훈: 지식을 늘리는 것, 원문을 저장하는 것, 좋은 질문을 고르는 것, 설명을 실제 전달하는 것은 다른 과제다. 경계를 흐린 채 기능을 누적하면 비용과 검증 충돌만 늘 수 있었다. 계획을 수행으로 기록하는 오류는 문서의 겉보기 완성도보다 중요했다. 문자열 검사는 의미 검증의 대체물이 아니었다.
한계: 공개 3증례 반복에 따른 과적합 가능성, 버전별 비동시 실행, 모델·환자 경로 변동, 상세 채점 비공개, 반복 대조 부족, 검수 전 지식, 실제 환자 및 외부 임상 검증 부재가 있다. 통계적 유의성·일반화·임상 안전을 주장하지 않는다. 모든 SOAP의 임상 충실도를 전수 판정하지도 못했다.
기여 구분
- 기존 팀: MedDB 참조·임상 지식, E2·B1, 팀원 PR6 구현 및 보고된 리더보드 결과.
- 이번 개발: 독립 하네스와 실험 분기, RAG 단계, 관찰·안전 전달 검증, Q1 회귀 분석, B1O1 reader, 패키징·재생·의사결정 기록.
- 개발 방식: 사용자 요구·승인과 AI 코딩 지원을 통한 구현·검토. 저자·소속·IRB·독립 임상 검수자 정보를 임의로 작성하지 않았다.
- 공개 범위: 집계·구현·테스트·출처·그림. 키·개인 원문 실행 로그·제출 ZIP은 제외한다.